AI 新知识 Jev 详解:在 FAB 晶圆厂能做什么、怎样用到极致
2026 年 9 月,TypeSafe AI 公开了首个 System One 模型 Jev。它不是「又一个会聊天的大模型」,而是专门给软件用的高速结构化决策引擎:输入程序状态 + 类型化问题,输出带校准概率的答案,且不生成自由文本。
本文用小白也能跟上的方式讲清:Jev 是什么、和 LLM 差在哪、在 FAB(晶圆厂) 里最有价值的切入点,以及怎样设计才能最大化收益。关键数字与定义以官方发布为准,并补充独立评测的审慎看法。
阅读提示
- 官方发布文:Introducing System One Models & Jev(2026-09-15)
- 工程集成说明:LangChain · Building a Harness with Jev
- 厂商关于速度/成本的对比多为自评;独立评测显示能力「参差」(见文末)。FAB 落地请先做小流量对照实验。
一、一句话记住 Jev
Jev = 面向自动化的「智能 if / switch」:不写长文章,只在你规定好的选项里,快速给出「选谁、打几分、是否成立」以及靠谱的概率。
官方比喻:像一次 frontier-intelligence function call——非结构化状态进,类型安全的概率决策出。
来源:TypeSafe 发布文
名字来源:
- System One:呼应卡尼曼《思考,快与慢》里快速、直觉式的 System 1(官方写法为 System One Models)
- Jev:纪念经济学家 William Stanley Jevons(杰文斯)——效率提升往往带来更大用量(杰文斯悖论);TypeSafe 用它暗示「决策智能变便宜后,应用面会爆炸式增加」
二、它到底新在哪里?和 ChatGPT 类 LLM 对比
| 维度 | 常见 LLM(ChatGPT 等) | Jev(System One) |
|---|---|---|
| 优化目标 | RLHF / 人类偏好、可验证奖励等 | RLCD:Reinforcement Learning for Calibrated Decisions(为校准决策做强化学习) |
| 输入侧重 | 对话消息流 | 程序状态(文本或结构化上下文) |
| 输出 | 字符串(可能幻觉、格式错) | 预先定义的类型答案 + 概率/置信度 |
| 采样 | 自回归,一个 token 接一个 | 并行,一次回答多个问题 |
| 端到端时延(官方) | 秒~百秒级(视推理强度) | 约 70ms~500ms |
| 价格(官方标价) | 输入/输出均计费,输出常更贵 | 输入约 $0.042 / MTok,输出免费 |
| 幻觉/类型错误 | 仍可能 | 官方称输出空间预定义,不会类型错误;「不能幻觉」指不能自由编造不在选项里的答案 |
来源:同上 TypeSafe 发布文;集成视角见 LangChain 指南。
flowchart LR
  S["state
告警摘要/批次上下文"] --> J["Jev"]
  Q["questions
Choice / Score / Noul"] --> J
  J --> O["并行概率答案"]
  O --> C["你的代码
路由/门槛/放行"]
三种问题类型(写进代码的「题型」)
LangChain / TypeSafe 文档归纳为三类:
- Choice:在给定选项里选(返回各选项概率 + 置信度)
- Score:有序等级打分(如低/中/高)
- Noul:是/否命题,返回「为真」的概率
同一 state 可挂多个问题,几乎并行评估——这是最大化用法的关键。
来源:LangChain · What Is Jev
示意(结构来自公开示例,内容换成 FAB 语境):
1 | |
你的程序根据概率设门槛,例如:is_true_alarm > 0.85 且 severity 峰值在 hold_lot → 自动 Hold,并推送工艺工程师。
三、先建立正确预期:Jev 不会替代什么
| 你想做的事 | 更合适的工具 |
|---|---|
| 写异常报告、根因叙述、邮件、会议纪要 | LLM(内网 GLM 等) |
| 自由生成工艺菜谱/代码 | LLM + 强校验 |
| 毫秒~亚秒级分类、路由、放行/拦截 | Jev |
| 多步复杂推理、长链条数学推导 | 官方与独立评测都提示 Jev 不是强项;交给推理 LLM |
| 纳米级缺陷像素分割、量测回归 | 专用视觉/统计模型;Jev 可做「结果之上的决策层」 |
LessWrong 独立基准概括:Jev 在部分「有界选择/监控」任务上很强、很便宜,但在需要多步推理的任务上可落到接近早期 GPT 水平——能力很不均匀(jagged)。
来源:Benchmarking Jev against no-CoT LLMs
公开架构细节有限的整理:Coachix · Jev AI
FAB 里的正确姿势:Jev 是 MES / FDC / APC / Agent 流水线里的决策闸门,不是「全厂一个大模型包办」。
四、FAB 厂为什么特别吃这套能力?
晶圆厂特点是:
- 事件密度极高:FDC 传感器、SPC、缺陷、WAT/CP、机台状态,每秒都在产生「要不要动」的决策
- 错一次很贵:误 Hold 伤产能,漏 Hold 伤良率与客户
- 大量决策其实是结构化的:真假告警、是否派工程师、是否改 APC、是否换机台、工单优先级……
- LLM 全量上决策太慢太贵:上千条告警若每条都跑一遍长推理,延迟与费用都会爆
行业背景(AI 已在 FAB 落地,但多为视觉/排程/FDC 大模型,与 Jev 不同层):
- 台积电 × NVIDIA:光刻仿真、缺陷视觉、排程、FabTwin 等——NVIDIA 新闻稿
- 国内 12 吋厂 AI-FDC / Agent 实践(如 FabSyn FDC 等)——智现未来案例
Jev 的切入点是:在这些系统之上或之间,加一层 「快、可校准、可编程」的决策皮层。
五、Jev 在 FAB 的十大高价值场景(由易到难)
5.1 FDC / 告警真假分流(最先做,ROI 最高)
传统痛点:假告警淹没工程师(业界 AI-FDC 也在攻这个点,见上引 FabSyn 文)。
Jev 用法:把「告警上下文 + 近期同腔体历史摘要」做成 state,并行问:
- Noul:是否更像 True Alarm
- Choice:建议动作(忽略 / 观察 / Hold / Tool Down / 升级 PE)
- Score:对在制 lot 风险
价值:毫秒级过滤,只把高概率真警推给人;LLM 只在「真警」上写根因草稿。
5.2 派工与升级路由(PE / EE / 白班夜班)
根据模块、班次、技能矩阵、在制产品等级,Choice 路由到正确责任组,减少「踢皮球」。
5.3 Lot / 机台调度的「软约束裁决」
排程引擎算完候选后,用 Jev 对「是否违反隐性工艺偏好」(如某产品忌连续某腔体)做 Score;硬约束仍由 APS/OR 求解器负责。
5.4 APC / R2R 变更放行闸门
在自动微调配方前:
- Noul:本次建议是否落在历史安全包络
- Noul:是否需人工批准
低置信度 → 强制人审。这与「Agent 工具调用前风险分类」同构(LangChain AutoMode 思路):LangChain 文 · Auto Mode
5.5 缺陷检测后的「处置决策」
视觉模型给出缺陷类与置信度后,Jev 决定:复检 / 报废倾向 / 加测 / 通知客户质量窗口——把 CV 分数变成工厂动作。
5.6 良率波动:先分流再深挖
Daily yield dip:先 Choice「系统性偏移 / 单一机台 / 量测异常 / 来料嫌疑」,再触发对应分析 Agent(LLM + 统计脚本)。避免一上来全厂大分析。
5.7 预防性维护触发
综合振动、粒子、RF、腔体寿命文本化摘要 → Score「距故障风险」,超过阈值生成 PM 工单优先级。
5.8 变更管理(ECO / 配方变更)风险评估
把变更单摘要喂给 Jev:并行评估对关键产品层的风险等级,决定灰度比例与监控时长。
5.9 厂内 Copilot / Agent 的模型路由与护栏
- Model routing:简单查表走小模型,复杂根因走大模型——LangChain 已给中间件示例
- 工具护栏:执行「改机台参数 / 下 Hold / 跑 SQL」前,用 Jev 做危险动作分类
这对你之前规划的「内网 GLM Agent + Oracle 审核」特别契合:
GLM 负责说与写,Jev 负责卡与分,Oracle 网关负责数据权限。
5.10 海量日志 / 事件的 Map-Reduce 特征化
官方强调 System One 适合把海量数据压成特征与洞察。FAB 的 event log、alarm storm 可用批量 Jev 打标,再进数仓做趋势。
六、怎样才能「最大化」地使用 Jev?
下面按「收益杠杆」排序——这比「到处接 API」重要得多。
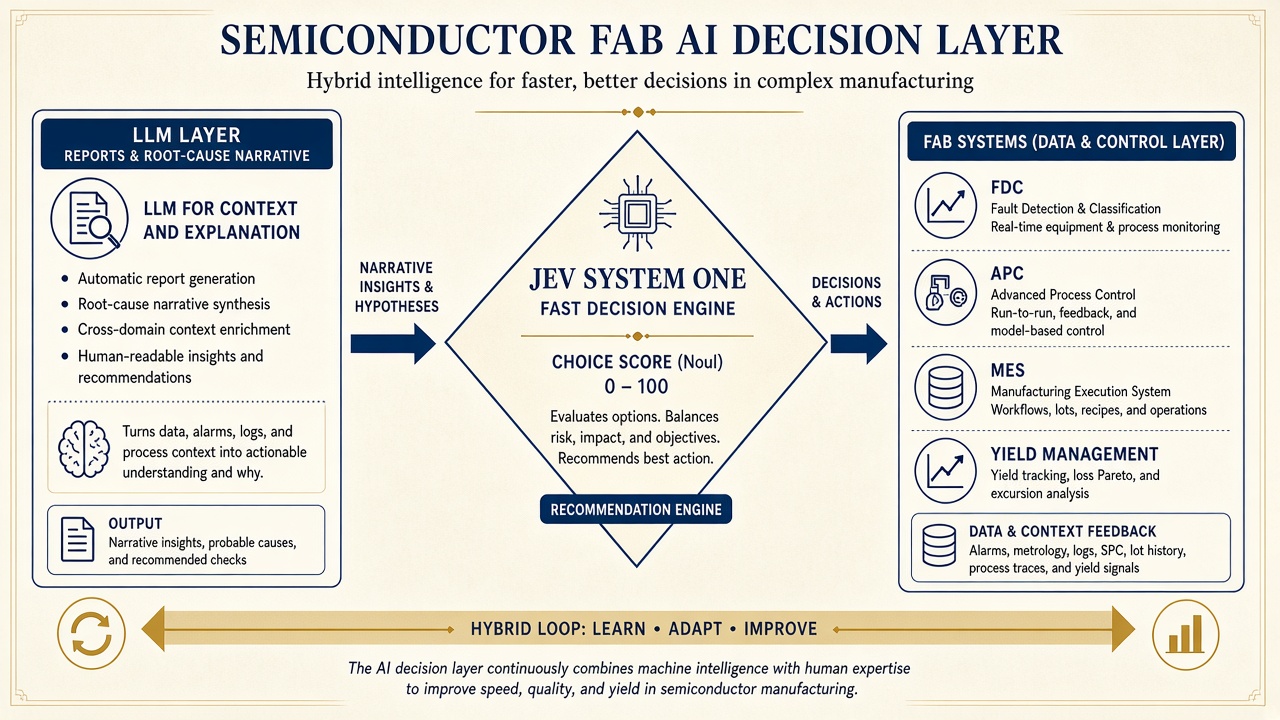
原则 1:LLM 负责慢思考,Jev 负责快决策(混合架构)
flowchart TB
  E["厂内事件流"] --> J["Jev 并行决策"]
  J -->|高置信自动| A["自动化动作
Hold/路由/过滤"]
  J -->|中置信| H["人审队列"]
  J -->|需解释/报告| L["内网 LLM
根因叙述/邮件"]
  L --> H
最大化公式:
1 | |
原则 2:一次 state,问尽相关问题(吃透并行)
不要为每个小判断单独打一枪。一次请求打包 5~15 个 Noul/Choice/Score,用代码组合逻辑。
官方与 LangChain 都强调:多问题几乎不增加时延,只增加少量输入 token。
原则 3:用「校准概率」写门槛,而不是用「感觉」
RLCD 的卖点是:标 0.9 的决策,整体上大约 90% 时候是对的(厂商宣称的校准目标)。
最大化用法:
- 上线前用历史工单做 可靠性图(calibration curve)
- 分场景设阈值:假警过滤可偏严(少漏),自动 Tool Down 必须极严
- 低置信度一律升级人工——这是自动化能做大的前提
官方对比表强调:LLM 即便被要求给置信度也常过度自信。来源:TypeSafe 发布文
原则 4:把工厂 Know-how 写进 instructions 与选项,而不是指望模型「懂 FAB」
Jev 的选项空间由你定义。最大化 = 工艺/设备专家参与出题:
- Choice 的枚举要对齐你们现有 SOP 动作码
- Noul 的命题要可事后用结果验证(是否真的是真警、是否真的该 Hold)
- 避免模糊题:「情况严不严重?」→ 改成可观测命题
原则 5:结果回灌,形成「决策 → 结果」数据飞轮
每周自动统计:
| 指标 | 含义 |
|---|---|
| 自动过滤准确率 | 被忽略告警中后续证实为假警的比例 |
| 漏检率 | 未升级但后续造成报废/客诉 |
| 平均 MTTR | 引入前后对比 |
| 置信度分桶准确率 | 是否仍校准 |
有标签后,才能谈微调/重标定或调整阈值。没有飞轮,Jev 只是「更便宜的分类器」。
原则 6:嵌进现有 EI,而不是另起炉灶
对接优先级建议:
- FDC / Alarm Manager(假警过滤)
- MES Hold / Release 建议(先建议后自动)
- 厂内 Agent 护栏与模型路由
- APC 放行
参考国内「不替换原有 FDC、轻量叠加 AI」的落地思路:FabSyn FDC 案例——模式可借鉴,产品与 Jev 无关。
原则 7:安全与合规(FAB 必做)
- 生产写操作:默认人审,Jev 只出建议;高置信可逐步放开「只读动作」(过滤、路由)
- 提示与 state 中脱敏:配方关键参数、客户名、良率绝对数按厂规处理
- 外网 API(TypeSafe 云)若不能出厂,需评估:私有化/专线是否在产品路线图;在未解决前,用「可出境的脱敏摘要」或自建同类决策模型做影子模式
- 审计:每次决策存
state 哈希、问题、概率、动作、操作者
原则 8:别用它做多步根因推理
独立评测显示多步推理偏弱。FAB 根因仍应用:
1 | |
七、一套可落地的 90 天最大化路线图
| 阶段 | 周期 | 做什么 | 成功标准 |
|---|---|---|---|
| 0. 对照 | 2 周 | 历史告警回放,Jev vs 现网规则 vs 人工标签 | 校准曲线、PR 曲线可画 |
| 1. 影子 | 4 周 | 只旁路建议,不自动动线 | 工程师采纳率 > 约定值 |
| 2. 半自动 | 4 周 | 高置信假警自动降噪;真警自动建单 | 假警打扰 ↓,漏检受控 |
| 3. 扩展 | 持续 | 派工路由 → Agent 护栏 → APC 闸门 | 决策调用量上升但 LLM 费用下降 |
最大化的标志不是「调用次数最多」,而是:
单位良率/产能改善下,人工决策负担与 LLM 账单同时下降。
八、和你厂内 AI 体系怎么拼(一张图)
1 | |
这是目前把 Jev 用到「极致」 的务实形态:它站在「每一次要不要动」的咽喉位置,而不是替代 FAB 里所有 AI。
九、风险与水分(务必读)
- 速度/成本数量级(如约 200×、400×)来自 TypeSafe 工作流评测与主页宣称,场景依赖强,需自测。
- 架构与训练细节未完全公开,复现困难——见 Coachix 综述。
- 能力 jagged:监控/分类强,多步推理弱——见 LessWrong 评测。
- FAB 数据出境与实时性:云 API 未必过得了厂级安全;最大化之前先过信息安全与网闸方案。
- Jev 不能替代专用缺陷视觉、光谱/量测模型;它吃的是「已经文本化/结构化的状态」。
十、参考链接
- TypeSafe:Introducing System One Models & Jev
- LangChain:Building a Harness with Jev
- LessWrong:Benchmarking Jev
- Coachix:Jev 资料与局限整理
- NVIDIA × TSMC:AI in Fabs
- 智现未来:FabSyn FDC 12 吋实战(AI-FDC 背景)
十一、结语
- Jev 是 2026 年冒头的 System One「决策模型」:快、结构化、带校准概率,不负责聊天写作。
- 在 FAB,它最该吃的是海量 「要不要动、往哪走、险不险」 的咽喉决策——尤其 FDC 真假警、派工、Agent/APC 护栏。
- 最大化的关键不是多接接口,而是:并行出题、概率门槛、人机分级、结果回灌、LLM+Jev 分工、安全合规先过关。
若你补充厂内是「更偏 FDC」还是「更偏 Copilot Agent」,可以再写一版只含问题模板(Choice/Noul 题库)与阈值表示例的实操附录。